Site menu:

cNORM - Kontinuierliche Normierung mit cNORM in jamovi
jamovi ist eine intuitive, kostenlose und quelloffene Statistikplattform auf R-Basis. Wir haben das Modul cNORMj zur jamovi-Bibliothek beigesteuert, das Ihnen den vollen Funktionsumfang des R-Pakets cNORM (v3.7.0) zur Verfügung stellt. Es umfasst die Datenaufbereitung (Altersgruppenbildung und Raking zur Stichprobengewichtung), die Normwertermittlung für Einzelgruppen sowie die kontinuierliche Normierung mittels verteilungsfreier und parametrischer Verfahren.
1. Datenvorbereitung (Altersgruppen & Raking-Gewichte)
Eine repräsentative Testnormierung erfordert häufig vorbereitende Schritte. Das Modul Data Preparation stellt Ihnen hierfür zwei zentrale Werkzeuge zur Verfügung:
- Bildung von Normgruppen:
Teilt eine kontinuierliche erklärende Variable (z. B. chronologisches Alter) in diskrete Normgruppen ein und ermittelt den jeweiligen Gruppenmittelwert. Dies ist besonders hilfreich für diagnostische Vorabanalysen sowie für die verteilungsfreie kontinuierliche Normierung.
- Anzahl der Normgruppen: Bei Eingabe von
0ermittelt cNORMj die Gruppenanzahl automatisch (Zielwert ca. n ≥ 100 Fälle pro Gruppe, mindestens jedoch n ≥ 50). Alternativ kann eine feste Gruppenanzahl vorgegeben werden. - Äquidistante Intervalle: Unterteilt die Altersspanne in gleich breite Zeitintervalle. Ist die Option deaktiviert (Standard), werden Intervalle mit annähernd gleicher Fallzahl gebildet.
- Tabelle & Diagramm: Gibt eine Übersichtstabelle mit Gruppenmittelwert, Intervallgrenzen, Fallzahlen und Prozentanteilen aus, ergänzt durch ein Balkendiagramm zur Überprüfung der Gruppenstärken (mit Referenzlinien bei n = 50 und n = 100).
- Speichern: Die Gruppenmittelwerte können als neue Variable direkt in den Datensatz übertragen werden.
- Anzahl der Normgruppen: Bei Eingabe von
- Post-Stratifikation / Raking-Gewichte:
Gleicht Verzerrungen der Normierungsstichprobe (z. B. nach Geschlecht, Migrationshintergrund, Bildungsabschluss oder Region) über Iterative Proportional Fitting (Raking) aus. Es werden Gewichte berechnet, die in der Modellierung verwendet werden können.
- Schichtungsvariablen: Wählen Sie eine oder mehrere kategoriale Variablen aus. Die Analysetabelle zeigt umgehend alle im Datensatz vorkommenden Merkmalsstufen und beobachteten Stichprobenanteile an und erzeugt in der Fußnote eine anpassbare Vorlage.
- Populationsanteile: Geben Sie die Soll-Anteile der Population nach dem Syntax-Muster der Vorlage ein (z. B.
sex: 1=0.51, 2=0.49; migration: 0=0.68, 1=0.32). Pro Variable sollten sich diese zu annähernd 1.0 ergänzen. - Gewichte standardisieren: Skaliert die Raking-Gewichte so, dass das kleinste Gewicht 1.0 beträgt (erleichtert die Weiterverwendung in gewichteten Regressionen).
- Diagnostik: Weist Minimal-, Maximal- und Mittelwert aus, analysiert Design-Effekte (Kishs Deff) und die effektive Stichprobengröße (Neff) aus.
- Speichern: Speichert die berechneten Personengewichte direkt als Variable im Datenblatt ab.
2. Normierung von Einzelgruppen (Ohne Altersabhängigkeit)
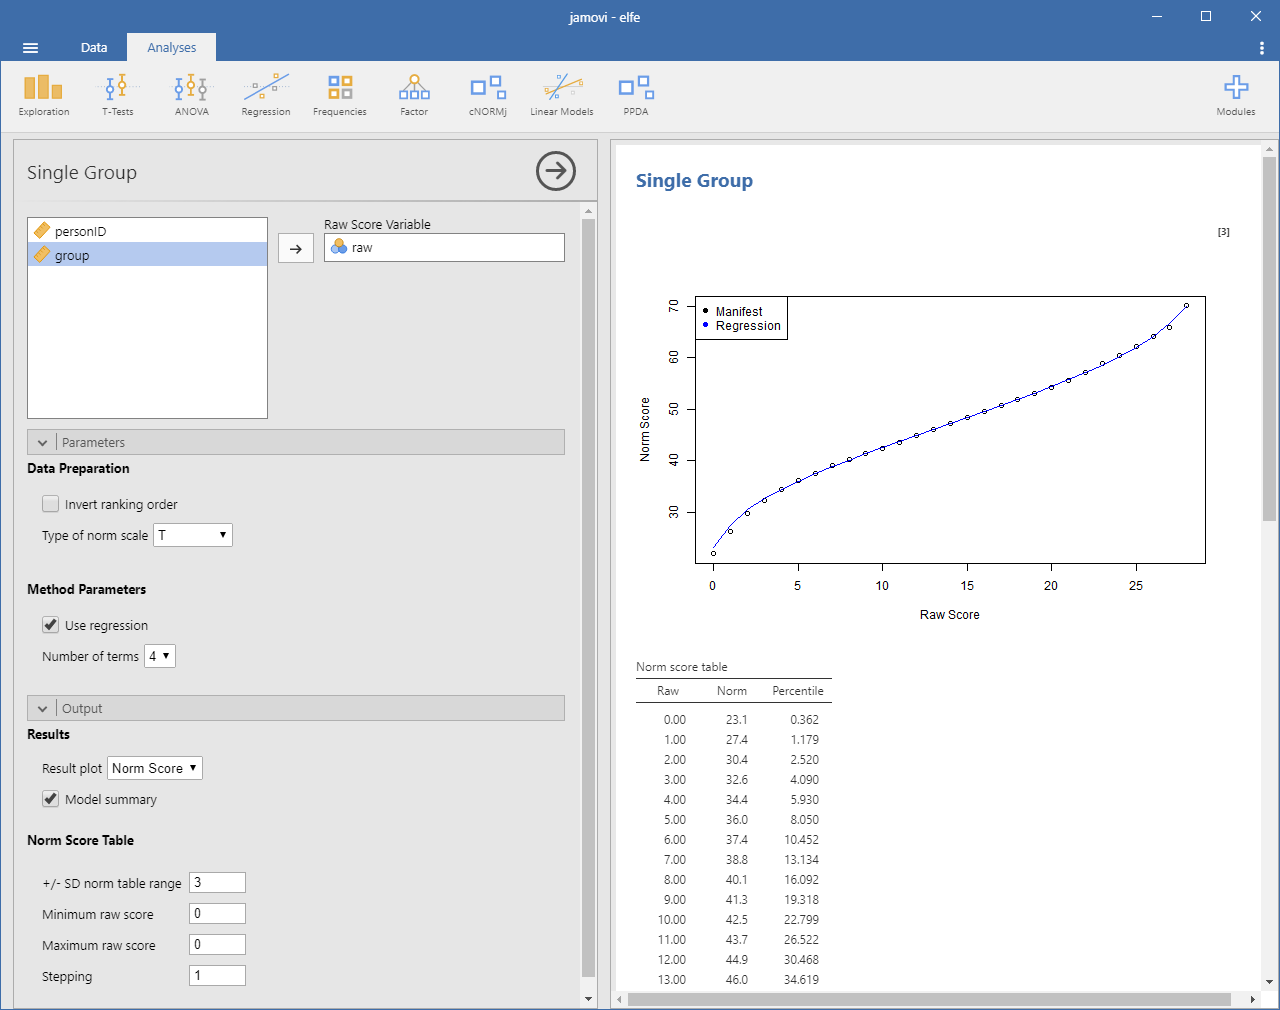
Dieses Analyseverfahren berechnet Normwerte und Perzentilbänder für eine homogene Population ohne Alters- oder Klassenstufenabhängigkeit. Die Normierung basiert auf der Rankit-Methode und inverser Normaltransformation. Zur Glättung von Stichprobenfehlern und zum Schließen von Lücken bei nicht beobachteten Rohwerten kann der Zusammenhang über eine polynomiale Regression bis zur 6. Potenz modelliert werden.
Wählen Sie Ihre Rohwertvariable aus und konfigurieren Sie folgende Einstellungen:
- Datenvorbereitung & Modellparameter:
- Rangfolge invertieren: Aktivieren Sie diese Option bei Testverfahren, bei denen höhere Rohwerte eine geringere Leistung abbilden (z. B. Fehlerzahlen oder Bearbeitungszeiten).
- Normskala: Wählen Sie zwischen T-Werten (M = 50, SD = 10), IQ-Werten (M = 100, SD = 15), z-Werten (M = 0, SD = 1), Wechsler-Wertpunkten (M = 10, SD = 3) oder PISA-Skalen (M = 500, SD = 100).
- Mit polynomialer Regression glätten: Standardmäßig aktiviert. Bei Deaktivierung wird die Normtabelle rein manifest über Rankit-Ränge erstellt.
- Grad der Lokation (k) & Termauswahl: Legen Sie den maximalen Grad (1 bis 6) fest und wählen Sie zwischen automatischer Modellauswahl oder manueller Termanzahl. Erhöhen Sie die Werte um eine engere Anpassung zu ermöglichen, reduzieren Sie sie, um stärker zu glätten.
- Gewichte (optional): Hiermit weisen Sie Fallgewichte (z. B. Raking-Gewichte) zu. Wenn nichts spezifiziert wird, dann hat jeder Fall das gleiche Gewicht.
- Ausgabe & Visualisierung:
- Ergebnisdiagramm: Stellt die beobachteten Datenpunkte der Modellkurve für Normwerte oder Perzentile gegenüber. Bei aktivierten Konfidenzintervallen wird das Konfidenzband als transparenter Bereich eingeblendet.
- Modellübersicht: Liefert formatierte Tabellen für Modellgüte (N, Terme, RMSE, korrigiertes R², BIC) und Regressionskoeffizienten.
- Bereich der Normtabelle: Schränkt den Tabellenbereich in Standardabweichungen ein (Standard: ±3.0 SD).
- Rohwertgrenzen & Schrittweite: Bestimmt minimalen/maximalen Rohwert und die Schrittweite der Tabelle.
- Konfidenzintervalle: Berechnet True-Score-Konfidenzintervalle (verwendet Standardmessfehler und verschiebt die Intervalle unter Berücksichtigung der Regression zur Mitte) auf Basis der Reliabilität für ein gewähltes Konfidenzniveau (z. B. 90% oder 95%) für Normwerte und Prozentränge.
- Speichern:
- Ermöglicht das Übernehmen von manifesten Normwerten, manifesten Perzentilen sowie modellierten Norm- und Perzentilwerten als neue Variablen in den Datensatz.
3. Kontinuierliche Normierung (Verteilungsfrei & Parametrisch)
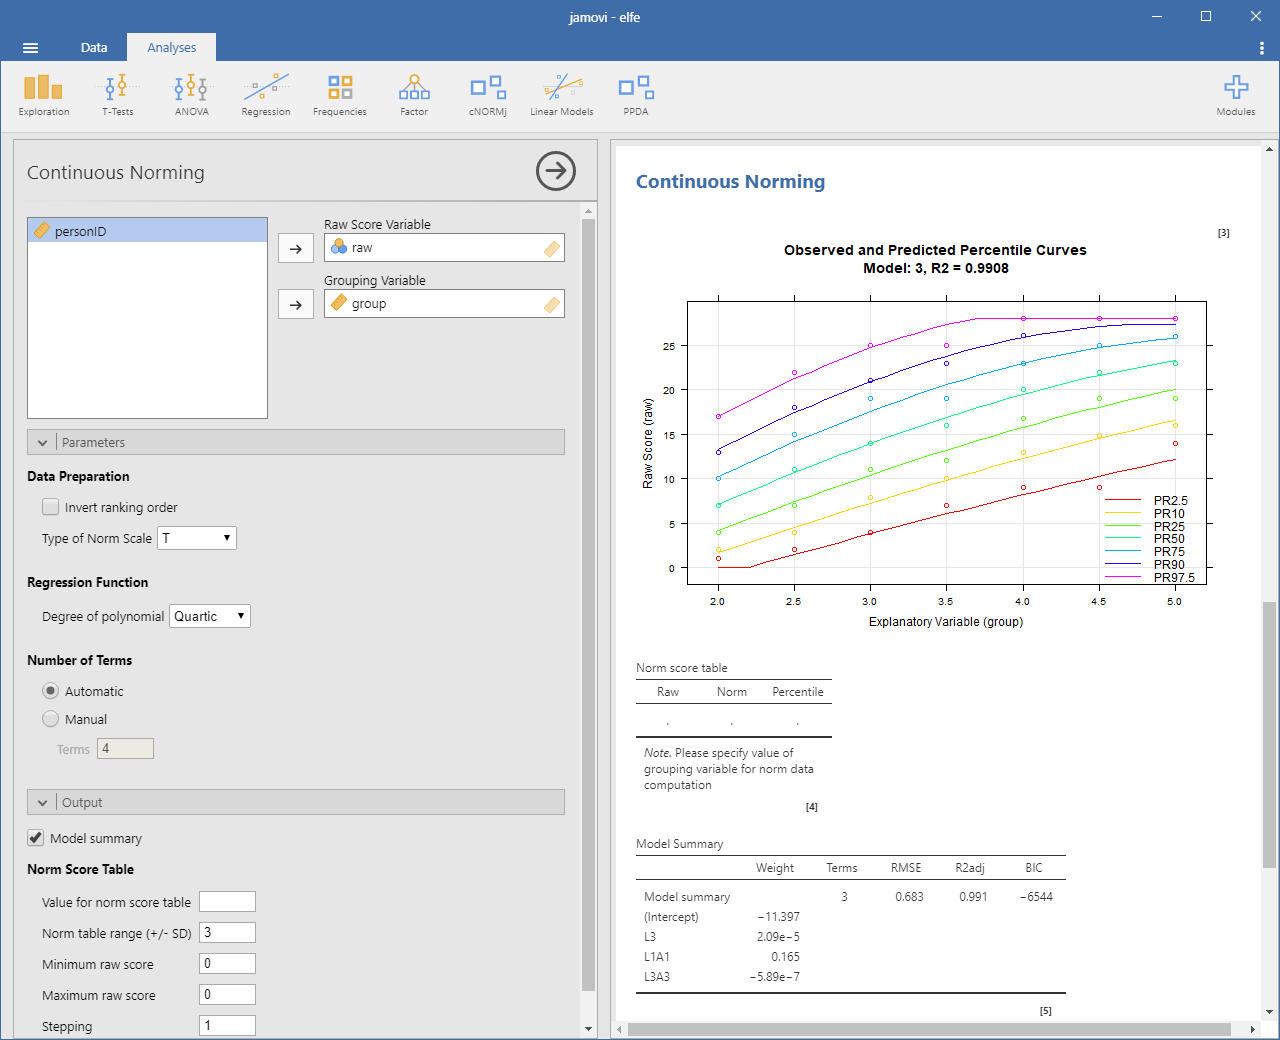
Anstatt eine Normstichprobe in starre Altersbänder zu zerlegen und jede Gruppe separat zu normieren, modelliert die kontinuierliche Normierung die Testleistung simultan über das gesamte Altersspektrum. Dies reduziert die benötigte Stichprobengröße drastisch, verhindert abrupte Übergänge zwischen Normtabellen und minimiert Stichprobenfehler (W. Lenhard & Lenhard, 2021). Die Analyse unterstützt vier Modellfamilien:
- Modellierungsansätze:
- Verteilungsfrei (Taylor-Polynome): Modelliert den Rohwert als zweidimensionale Polynomfunktion aus Personenfähigkeit (Normwert, Grad k) und Alter (Grad t) ohne Annahmen über die Verteilungsform. Liegt das Alter kontinuierlich vor, teilt cNORMj die Daten automatisch in gut besetzte Normgruppen ein. Die Gruppenanzahl kann auch manuell vorgegeben werden.
- Beta-Binomial: Speziell für Niveau- und Powertests mit fester Itemanzahl n (Rohwerte 0 bis n). Die Formparameter α und β variieren glatt über das Alter. Dieser Ansatz eignet sich ideal für 1PL/Rasch-skalierte Verfahren.
- Sinh-Arcsinh (SHASH): 4-parametrige kontinuierliche Verteilungsfamilie (Lokation μ, Streuung σ, Schiefe ε, Wölbung/Tails δ). Bildet nicht-normale, schiefe Verläufe, Reaktionszeiten oder biomedizinische Entwicklungsdaten flexibel ab. Der Parameter δ kann bei Bedarf fixiert werden (z. B. 1.0 für normale Tails).
- Conway-Maxwell-Poisson (CMP): Modelliert Speed-Tests, z. B. Häufigkeiten oder Ereignisse pro Zeit (nicht-negative ganze Zahlen). Erfasst über die Parameter μ (Lokation) und ν (Dispersion) sowohl Über- als auch Unterdispersion und unterstützt die Limitierung des Wertebereichs bei einem Maximalscore des Tests.
- Modellprüfung & Tabellenausgabe:
- Perzentildiagramm: Zeigt die modellierten Perzentilkurven (glatte Kurven bzw. exakte Sprungfunktionen bei Betabinomialverteilungen) im Vergleich zu den manifesten Gruppenperzentilen (Rauten) und Einzelbeobachtungen.
- Modellgüte & Koeffizienten: Weist N, Termanzahl, Log-Likelihood, AIC, BIC, R², RMSE und Bias sowie standardisierte Parameterschätzer mit Standardfehlern, z- und p-Werten aus.
- Normwerttabelle: Geben Sie das gewünschte Alter an (z. B.
normAge = 9.5), um eine exakte Normtabelle inklusive Konfidenzintervallen für Normwerte und Perzentile zu generieren.
- Speichern:
- Schreibt die kontinuierlich gefitteten Normwerte und Perzentilränge direkt zeilengenau als neue Variablen in den Datensatz zurück. Die Spalten werden bei Parameteränderungen automatisch aktualisiert.
4. Integrierte Übungsdatensätze
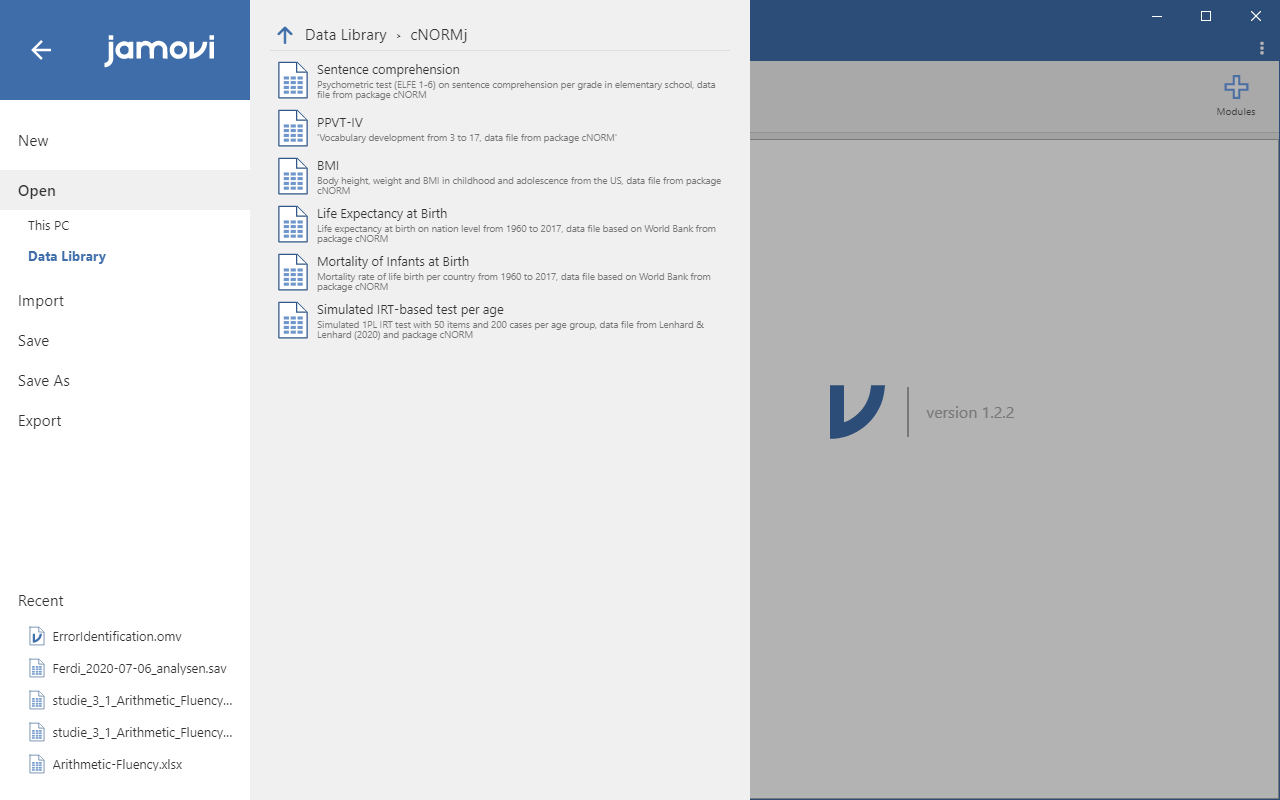
cNORMj bringt vier Datensätze des cNORM-Pakets mit, anhand derer Sie alle Verfahren direkt ausprobieren können. Klicken Sie zum Öffnen auf das jamovi-Menü oben links (drei horizontale Balken), wählen Sie Öffnen und navigieren Sie zu Data Library → cNORMj:
- Leseverständnis (ELFE 1-6): Lesetestdaten aus der Grundschule (Klassen 1-4, Rohwerte 0-28). Hervorragend geeignet für Taylor-Polynome und Beta-Binomial-Modelle.
- Wortschatzentwicklung (PPVT-IV): Standardisierungsdaten des Peabody Picture Vocabulary Test für die Altersspanne 2.5 bis 17.5 Jahre (Rohwerte 0-228). Enthält soziodemografische Variablen (
sex,migration) zur Demonstration des Raking; Modellierung mit Taylor-Polynomen und Sinh-Arcsinh-Modellierung (SHASH). - Biometrische Maße: Wachstumsdaten des CDC zu Größe, Gewicht und BMI von 2 bis 18 Jahren. Optimal zur Veranschaulichung von Taylor-Polynomen und der Sinh-Arcsinh-Modellierung (SHASH).
- Leseflüssigkeit (ELFE-II Speed): Speed-Test zur Dekodiergeschwindigkeit für die Klassen 2 bis 4 (Alter 7 bis 11, Rohwerte 0-75 mit Test-Deckel). Da kaum Fehler gemacht werden und es nur auf Geschwindigkeit ankommt passt hier die Conway-Maxwell-Poisson-Modellierung (CMP).
Installation
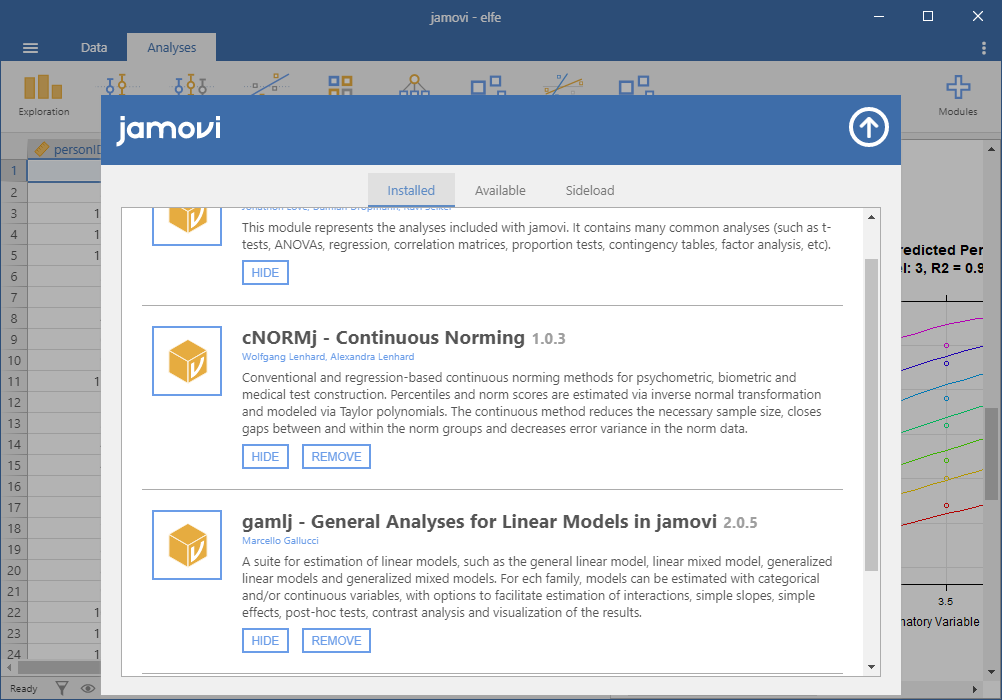
Das Modul 'cNORMj' ist über die Jamovi-Bibliothek für alle Plattformen verfügbar. Bitte klicken Sie oben rechts auf die Option 'Module'. Dort finden Sie eine Bibliothek für die Installation und Verwaltung der Module. Sie können das Modul auch für Win64 herunterladen und manuell über 'Sideload' installieren.
| Version | Name | Datum |
| Binary Package (Windows, 64 Bit) | cNORMj Module (v. 3.7.0) | 08.11.2026 |
 |
Grafische Oberfläche |
Rarely Asked Questions |
 |